📦 레포: kh20134/unlimited-ocr-llm-its (MIT, 업스트림 Baidu Unlimited-OCR 래퍼임)
1. 개요 및 배경
- 현장에는 통행료 영수증, VMS 점검일지, 차종별 요금정산표 같은 종이·PDF 문서가 계속 쌓임
- 사람이 눈으로 옮겨 적는 작업이 많고, 검색·집계가 어려움
- OCR로 글자를 읽고 LLM으로 정리하면 표 JSON·요약·질의응답까지 자동화 가능하다고 판단했음
- 초보자도 GPU·API 키 없이 끝까지 따라 해볼 수 있게 구성했음
2. Unlimited-OCR란
- Baidu가 공개한 OCR 모델임 (MIT, Copyright (c) 2026 Baidu)
- Hugging Face 모델 카드: baidu/Unlimited-OCR
- 원본 레포: github.com/baidu/Unlimited-OCR
- 긴 문서·여러 페이지 PDF를 마크다운(제목·문단·표)으로 한 번에 파싱하는 게 강점임
- BF16 약 33억 파라미터, 가중치 약 6.8GB, 최대 32,768 토큰 문맥임
3. 왜 OCR 다음에 LLM인가
- OCR 결과는 "글자"일 뿐, 의미 정리는 안 됨
- LLM이 붙으면 "통행료가 얼마?", "통신 점검 결과는?" 같은 질문에 바로 답함
- 표를 JSON으로 바꿔 DB·엑셀에 바로 넣을 수 있음
- 모델 재학습은 하지 않음. 가중치는 그대로 호출만 함
4. 전체 구조
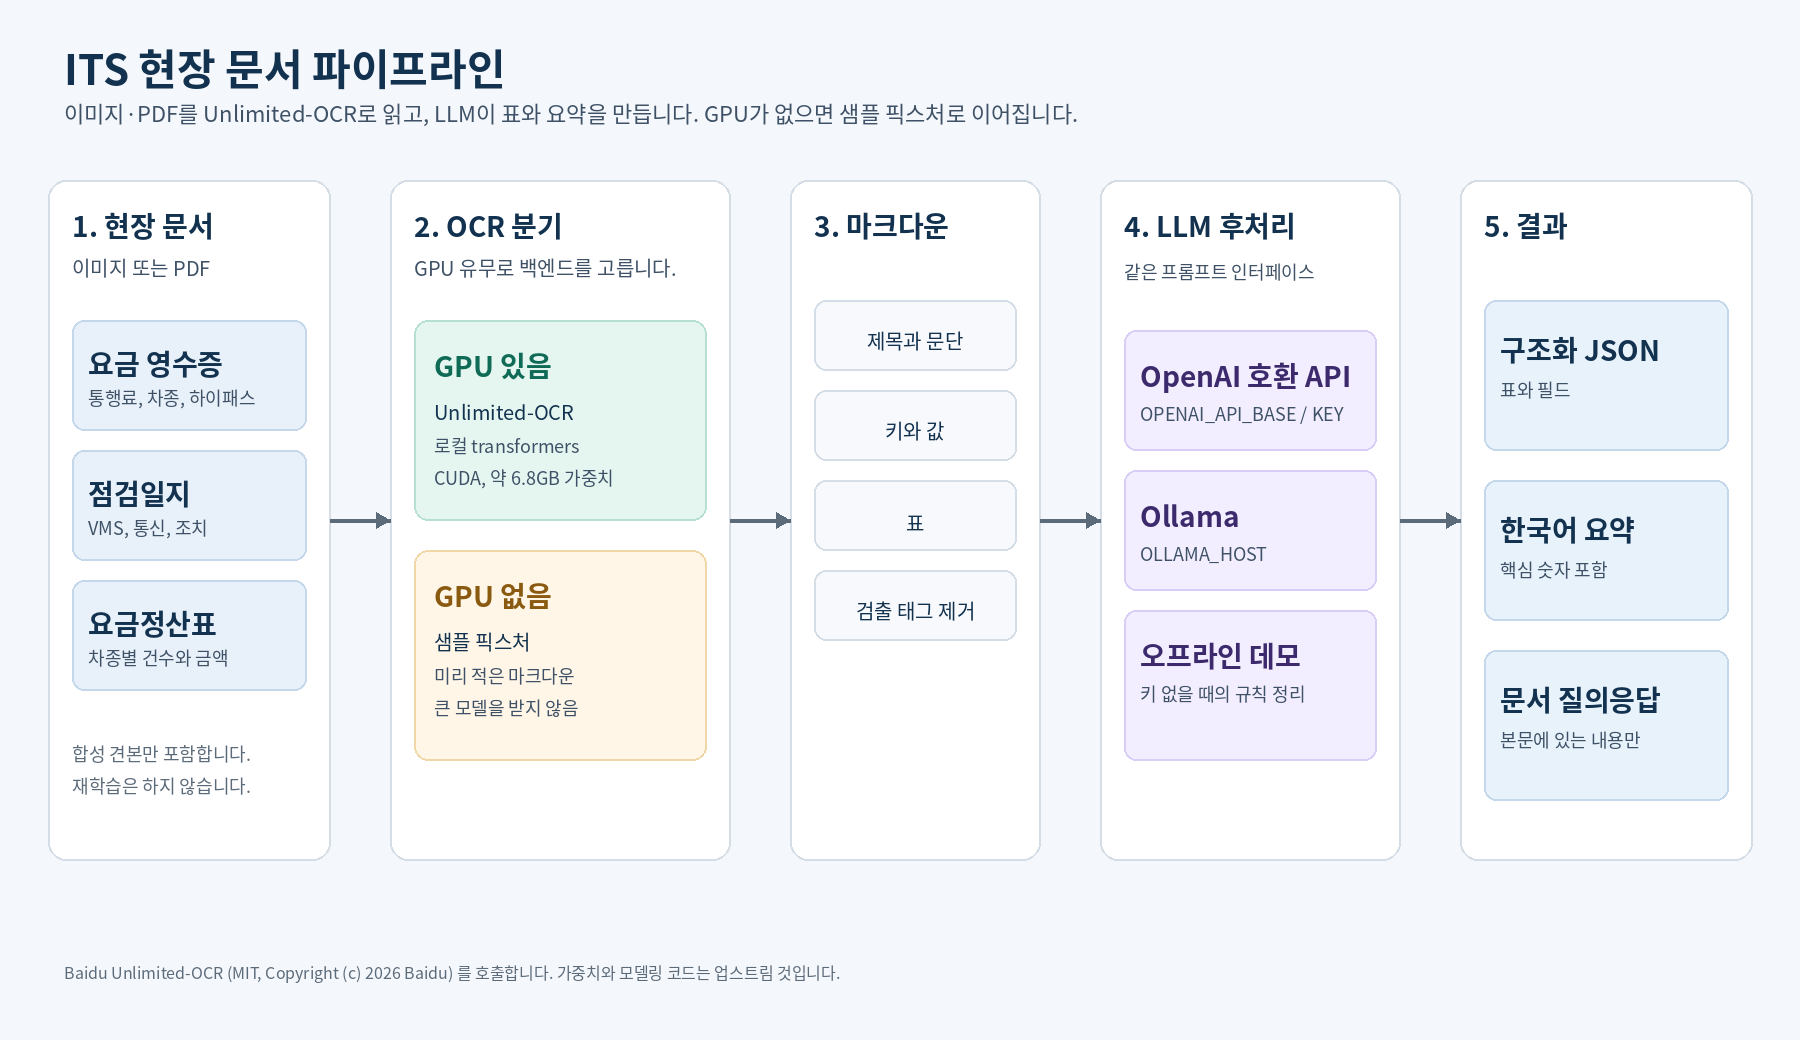
- 현장 문서 → OCR 분기 → 마크다운 → LLM 후처리 → 결과 순서임
- LLM은 OpenAI 호환 API, Ollama, 오프라인 데모 중 자동 선택함
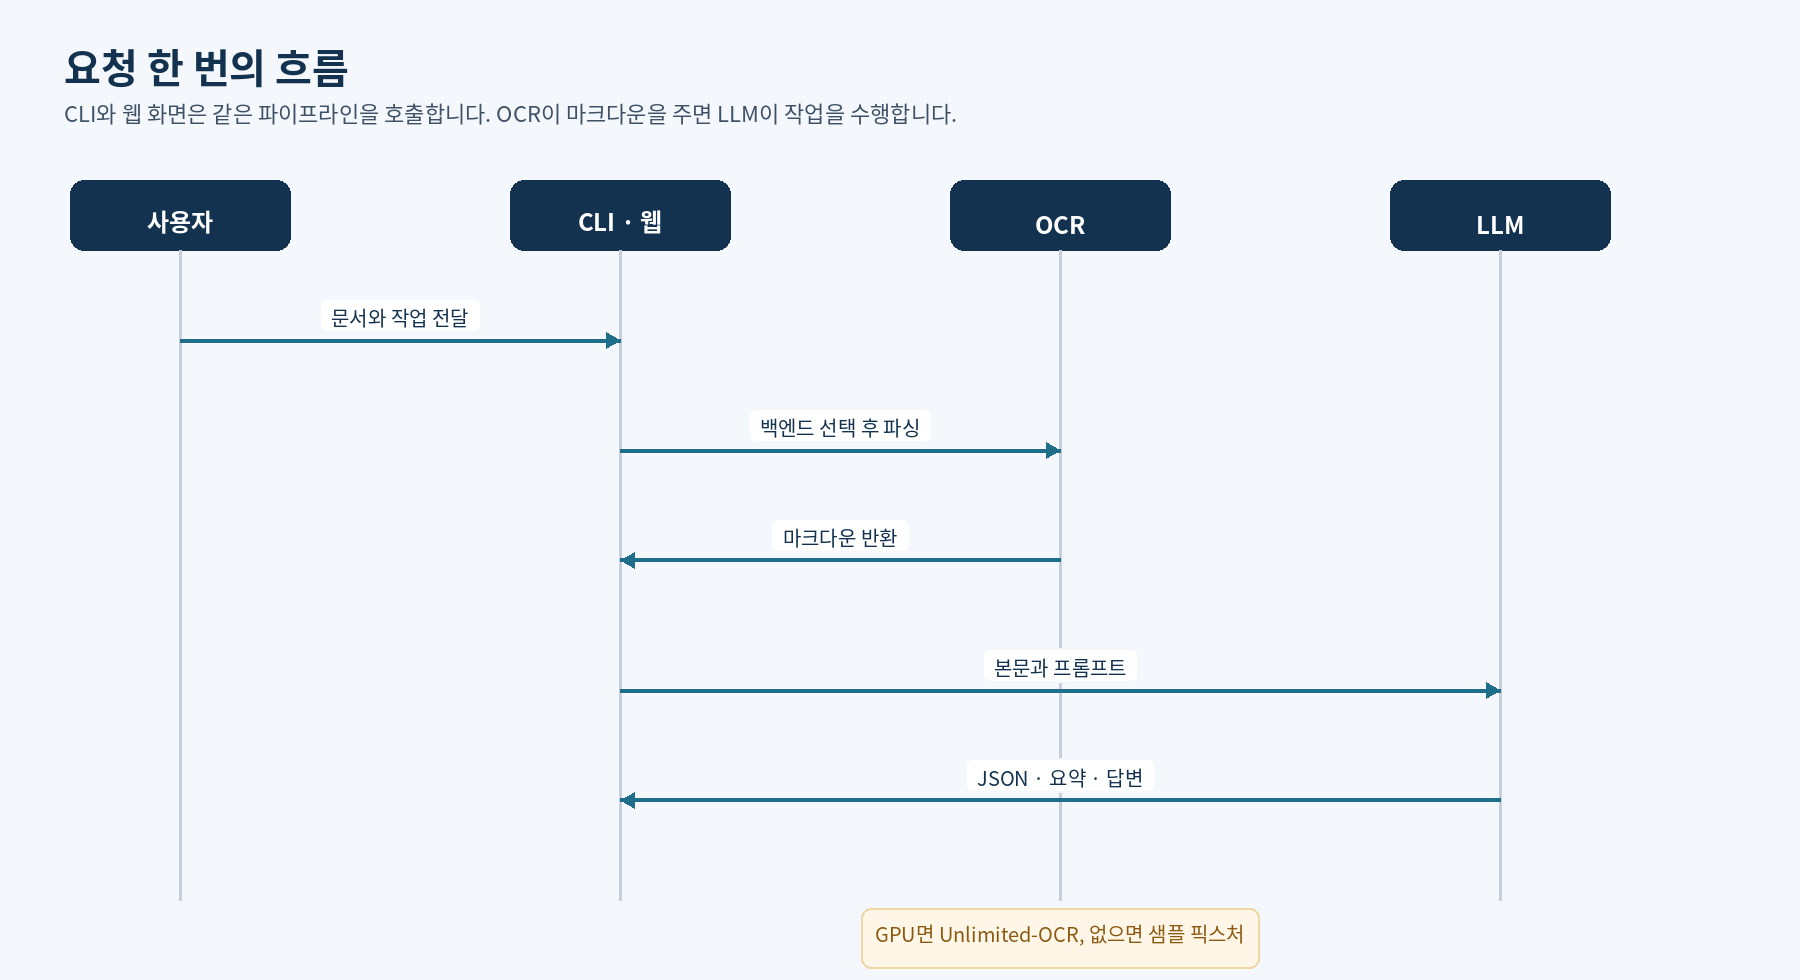
5. GPU 경로 vs 데모(픽스처) 경로
- GPU 있음: 업스트림 Unlimited-OCR를 transformers로 로컬 실행함 (NVIDIA CUDA 전용)
- 16GB 카드는 빠듯할 수 있고, 여러 페이지 PDF는 24GB 이상 권장임
- GPU 없음:
samples/fixtures/에 미리 적어 둔 마크다운을 읽어 이후 단계를 그대로 실행함 --backend auto만 GPU 없을 때 픽스처로 넘어감.--backend local은 이유를 알리고 멈춤- 픽스처는 사람이 적은 자리표시자라 실제 모델 출력이 아님을 명시했음
6. 초보 3단계 따라하기
1단계. 설치
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env.env는 비워둬도 됨. torch도 필요 없음
2단계. 샘플 실행
python -m ocr_llm_its run --input samples/toll_receipt.png --task summarize
python -m ocr_llm_its run --input samples/settlement_table.pdf --task extract
python -m ocr_llm_its run --input samples/inspection_log.png --task qa --question "통신 점검 결과는?"
3단계. 결과 확인
- 출력은 JSON이고
result에 요약·구조화 객체·답변이 들어감 ocr.backend가fixture면 큰 모델 없이 샘플을 읽은 것임llm.backend가offline이면 API 대신 규칙 기반 정리기가 동작한 것임
7. 샘플: 통행료 영수증
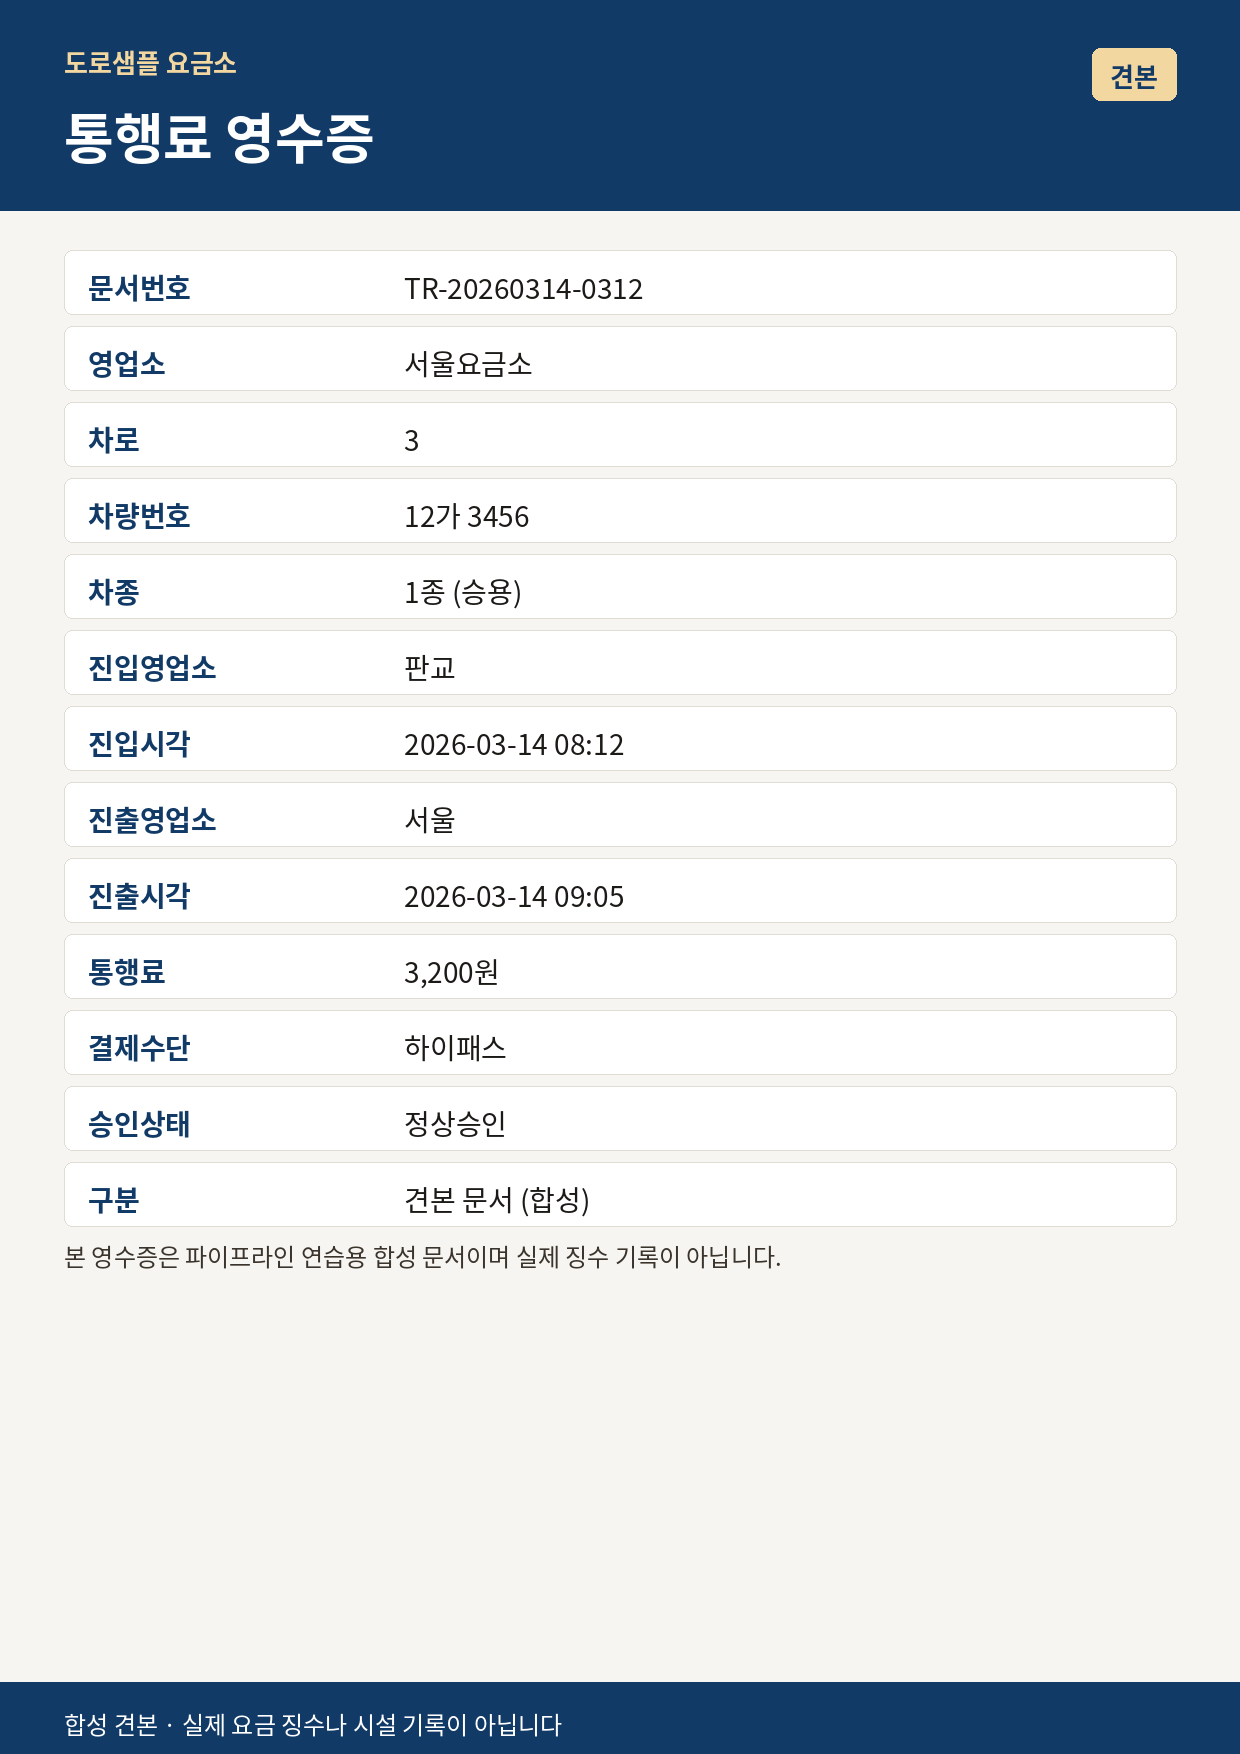
- 합성 견본임. 실제 징수 기록 아님
- 키 없이 summarize 결과: "문서 제목은 통행료 영수증 … 영업소 서울요금소, 차로 3, 차종 1종 (승용), 통행료 3,200원, 결제수단 하이패스"
8. 세 가지 작업
- extract: 표와 필드를
fields·tablesJSON으로 뽑음 → 정산 집계에 활용 - summarize: 핵심 숫자를 포함한 한국어 요약 → 보고용
- qa: 문서 본문에 있는 내용만 근거로 답변 → 점검일지 조회용
9. Gradio 화면
python -m ocr_llm_its ui- 브라우저에서
http://127.0.0.1:7860열면 됨 - 파일 올리고 작업 고르면 결과를 화면에서 바로 확인 가능함. 명령어 몰라도 됨
10. LLM 연결 설정
- OpenAI 호환:
OPENAI_API_BASE,OPENAI_API_KEY(기본 모델 gpt-4o-mini) - 로컬 LLM:
ollama pull qwen2.5:7b후--llm ollama - auto 순서: API 키 → Ollama → 오프라인 데모
- 현장 문서가 외부로 나가면 안 되는 경우 Ollama 로컬 구성이 안전함
11. 출처 및 라이선스
- Baidu Unlimited-OCR (MIT, Copyright (c) 2026 Baidu): GitHub · Hugging Face
- 논문: Unlimited OCR Works
- 가중치와 모델링 코드는 업스트림 것이고, 이 레포는 래퍼(MIT)임
12. 한눈에 정리
| 구분 | 내용 |
|---|---|
| OCR 모델 | baidu/Unlimited-OCR (MIT, 약 6.8GB) |
| GPU 있음 | 로컬 transformers, CUDA 전용 |
| GPU 없음 | 픽스처 마크다운으로 데모 |
| LLM | OpenAI 호환 / Ollama / 오프라인 |
| 작업 | extract · summarize · qa |
| 화면 | Gradio (127.0.0.1:7860) |
| 테스트 | GPU 없이 30개 통과 |
| 레포 | kh20134/unlimited-ocr-llm-its |