PDF를 한국어 문장 단위로 잘라 로컬 임베딩으로 바꾸고, Chroma 벡터 DB에 넣어 한국어 질문으로 찾는 파이프라인 pdf-vector-pipeline을 만들어 공개했어요.
GitHub: kh20134/pdf-vector-pipeline (MIT 라이선스)
프로젝트 개요
- 목표: 한글 PDF에서 질문과 관련된 구절을 파일·페이지 단위로 찾아 주기
- 기간: 2026년 10월
- 역할: 기획, 설계, 구현, 테스트
- 기술 스택: Python 3.11/3.12, PyMuPDF, pypdf, sentence-transformers, ChromaDB, pytest, GitHub Actions
왜 만들었나
현장에서 일하다 보면 지침, 매뉴얼, 감리 자료가 대부분 PDF로 쌓여요. 필요한 한 줄을 찾으려고 파일을 하나씩 여는 일이 잦았어요.
요즘 많이 말하는 RAG도 결국 "문서를 잘 잘라서 잘 찾는 것"에서 시작해요. 그래서 답변 생성보다 앞 단계인 추출·청킹·임베딩·저장을 먼저 제대로 만들어 보기로 했어요.
내부 문서를 다루는 경우를 생각해서, 임베딩은 기본값을 로컬 모델로 두었어요.
전체 구조
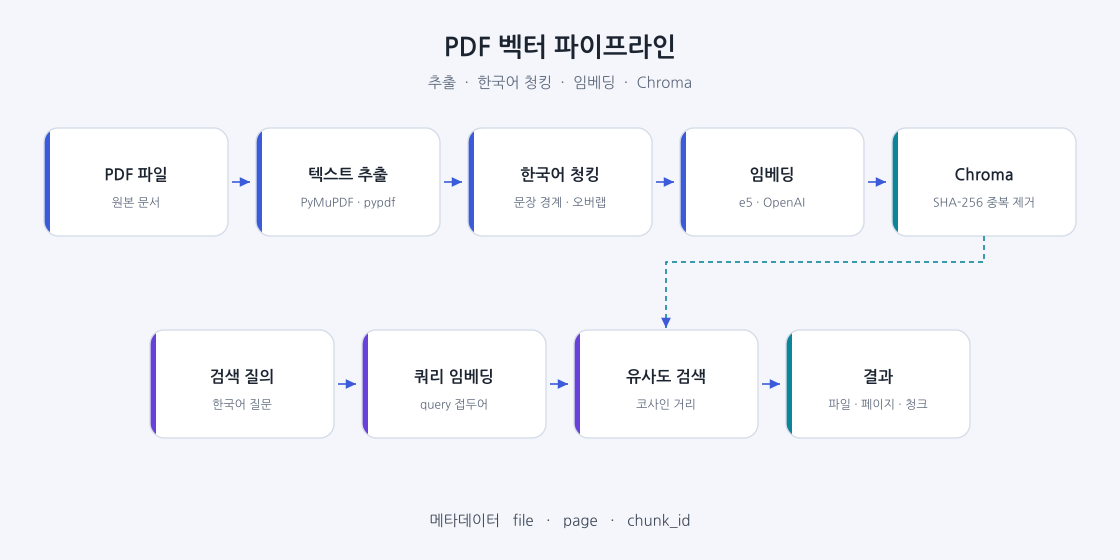
(구조도, 출처: 본인 깃허브)
위쪽 줄이 넣는 흐름(ingest), 아래쪽 줄이 찾는 흐름(search)이에요.
extract.py: 페이지별 텍스트 추출chunk.py: 한국어 문장 경계 청킹embed.py: 로컬 E5 또는 OpenAI 임베딩store.py: Chroma 저장, 중복 제거, 검색pipeline.py,cli.py: 한 흐름으로 묶은 명령
처리 과정
1단계: PDF 텍스트 추출
PyMuPDF로 페이지마다 글을 읽어요. 페이지 번호는 1부터 붙여요.
PyMuPDF가 예외를 내거나 모든 페이지가 빈 글자면 pypdf로 다시 읽어요. 글자가 없는 페이지는 결과에서 빼요.
try:
    pages = _extract_pymupdf(
        pdf_path)
except Exception:
    pages = _extract_pypdf(
        pdf_path)
else:
    if not any(p.text.strip()
               for p in pages):
        pages = _extract_pypdf(
            pdf_path)
2단계: 한국어 청킹
영문 기준 분할기는 "습니다", "요" 같은 한국어 어미를 잘 모르는 경우가 많아요. 그래서 문장 끝 패턴을 정규식으로 직접 정의했어요.
_BOUNDARY = re.compile(
    r"(?:"
    r"습니까|했습니까|였습니다|"
    r"했습니다|입니다|습니다|"
    r"합니다|했어요|..."
    r"|요|까|죠|네|다"
    r")[.!?…]+"
    r"|(?<!\d)[.!?。!?…]+"
    r"(?=\s|$)"
)
긴 어미를 앞에 두었고, 9.6처럼 숫자 뒤 마침표는 문장 끝으로 보지 않아요. (가운데 어미 일부는 지면상 줄였어요.)
- 청크 최대 길이 기본값은 400자, 겹침은 80자예요.
- 400자를 넘기 전, 청크 후반부의 문장 경계에서 끊어요. 경계가 없으면 공백, 그것도 없으면 그 자리에서 잘라요.
- PDF가 줄바꿈으로 자른 문장은 먼저 한 줄로 이어 붙여요.
- 청크는 페이지를 넘지 않아요. 그래야 결과에 페이지 번호를 붙일 수 있어요.
3단계: 임베딩
기본 모델은 로컬 다국어 모델 intfloat/multilingual-e5-small이에요. sentence-transformers로 돌려요.
E5 계열은 넣는 문장과 질문에 서로 다른 접두어를 붙이는 방식이라, 그 규칙을 지켰어요.
self._model.encode(
    [f"passage: {t}"
     for t in texts],
    normalize_embeddings=True,
    batch_size=32,
)
# 질문은 f"query: {text}"
환경 변수 PDFVEC_EMBEDDING_PROVIDER=openai로 OpenAI 임베딩(기본 text-embedding-3-small)도 고를 수 있어요. 이때는 접두어를 붙이지 않아요.
4단계: Chroma 저장과 중복 제거
Chroma 영구 저장소에 코사인 공간으로 컬렉션을 만들어요. 청크 아이디는 "파일 경로 + 페이지 + 본문"의 SHA-256이에요.
def chunk_sha256(
        file, page, text):
    payload = (
        f"{file}\0{page}\0{text}"
        .encode("utf-8"))
    return hashlib.sha256(
        payload).hexdigest()
메타데이터에는 이런 값을 함께 넣어요.
file: 작업 디렉터리 기준 상대 경로page: 1부터 시작하는 페이지 번호chunk_id:{file}:p{page}:c{번호}sha256,file_sha256,embedding_model
중복은 세 겹으로 막아요.
- 파일 바이트의 SHA-256이 같으면 임베딩을 다시 계산하지 않고 건너뛰어요.
- 파일이 바뀌었으면 그 파일의 기존 청크를 지우고 다시 넣어요.
- 같은 청크 아이디가 이미 있으면 그 청크는 추가하지 않아요.
5단계: 검색
질문을 같은 모델로 임베딩한 뒤 Chroma에서 가까운 청크를 가져와요. 기본 결과 수는 5개예요.
점수는 1 - 코사인 거리를 0~1로 자른 값이고, 결과마다 파일·페이지·청크 아이디를 함께 보여 줘요.
실행 화면
저장소에 있는 두 쪽짜리 한글 샘플 PDF(한라산, 성산일출봉 안내)로 돌린 결과예요.
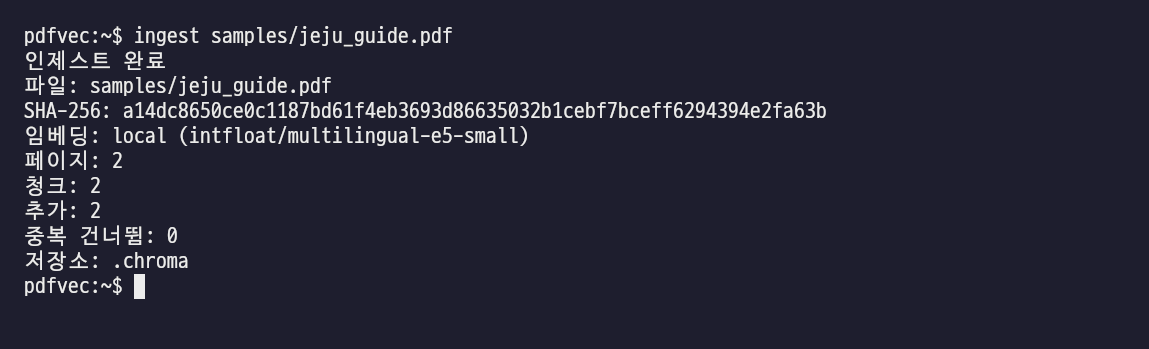
(ingest 실행 화면, 출처: 본인 깃허브)
2페이지에서 청크 2개를 만들어 모두 추가했어요. 같은 파일을 다시 넣으면 "중복 건너뜀"으로 처리돼요.
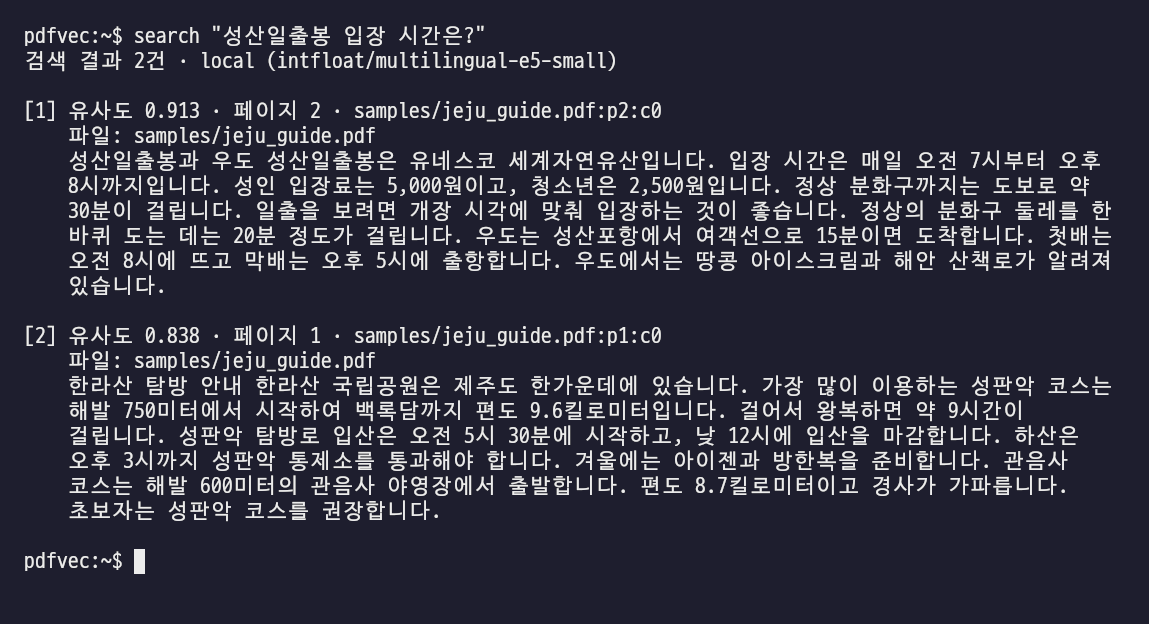
(search 실행 화면, 출처: 본인 깃허브)
"성산일출봉 입장 시간은?"이라고 물으니 성산일출봉 내용이 있는 2페이지가 유사도 0.913으로 1위, 한라산 내용인 1페이지가 0.838로 2위였어요.
사용법
python -m venv .venv
source .venv/bin/activate
pip install -e ".[local]"
ingest samples/jeju_guide.pdf
search "성산일출봉 입장 시간은?"pdfvec ingest \
samples/jeju_guide.pdf \
--persist-dir .chroma
pdfvec search \
"한라산 성판악 입산 마감" \
--top-k 3--chunk-size,--overlap: 청크 길이와 겹침(기본 400, 80)--persist-dir,--collection: 저장 경로와 컬렉션(기본 .chroma, pdfs)--provider: local 또는 openai--model: 임베딩 모델 이름
설계 선택과 트레이드오프
로컬 임베딩을 기본값으로
문서가 밖으로 나가지 않고 API 비용도 없어요. 대신 처음 실행할 때 모델을 받아야 하고, 속도는 PC 성능에 따라 달라요.
규칙 기반 문장 분할
형태소 분석기 없이 정규식만 써서 설치가 가볍고 동작을 예측하기 쉬워요. 대신 목록에 없는 어미나 구어체 문장은 경계를 놓칠 수 있어요.
페이지 안에서만 청킹
결과마다 정확한 페이지를 보여 줄 수 있어요. 대신 페이지 끝에서 이어지는 문장은 두 청크로 나뉘어요.
SHA-256 아이디
같은 파일을 여러 번 넣어도 벡터가 불어나지 않아요. 대신 파일이 조금만 바뀌어도 그 파일 전체를 지우고 다시 임베딩해요.
모델 섞임 방지
컬렉션에 저장된 모델과 요청한 모델이 다르면 오류를 내고 다른 저장 경로나 컬렉션을 쓰라고 안내해요. 차원이 다른 벡터가 섞이는 사고를 막으려는 장치예요.
if previous and \
        previous != model_name:
    raise RuntimeError(
        "임베딩 모델이 기존 "
        "컬렉션과 다릅니다. ...")
모델 없이 도는 테스트
CI에서는 임베딩 모델을 받지 않아요. 글자 n-gram을 해시로 바꾸는 결정적 가짜 임베더를 넣어 테스트해요.
테스트는 23개이고, GitHub Actions에서 Python 3.11과 3.12로 돌려요. 머지 커밋 기준 둘 다 통과했어요.
한계
- OCR이 없어요. 스캔 이미지로만 된 PDF는 "추출된 텍스트가 없습니다" 오류로 끝나요.
- 표, 다단 편집, 머리글·바닥글은 따로 처리하지 않고 추출된 글 순서대로 다뤄요.
- 한 번에 PDF 파일 하나씩 넣어요. 폴더 단위 일괄 처리는 아직 없어요.
- 검색은 벡터 유사도만 써요. 키워드 검색이나 재순위화는 없어요.
- 샘플은 두 쪽짜리 PDF 하나라서, 큰 문서에서의 검색 품질은 아직 따로 재지 않았어요.
다음 단계
- RAG 연결: 검색된 청크를 LLM에 넘겨 답하고, 파일·페이지를 출처로 함께 보여 주기
- 스캔 PDF를 위한 OCR 단계
- 폴더 단위 일괄 인제스트
- 키워드 검색과 섞는 하이브리드 검색, 재순위화
- 실제 업무 문서로 질문·정답 세트를 만들어 검색 품질 측정
위 항목은 계획이고, 현재 저장소에는 들어 있지 않아요.
배운 점
RAG 품질은 모델보다 청킹에서 먼저 갈린다는 걸 다시 느꼈어요. 한국어는 어미 하나, 소수점 하나 때문에 문장이 엉뚱하게 잘리기 쉬워요.
또 "같은 걸 두 번 넣지 않기"와 "다른 모델 벡터를 섞지 않기"처럼 운영에서 터질 문제를 처음부터 막아 두는 게 중요했어요. 현장 시스템을 운영하며 배운 습관이 여기서도 그대로 통했어요.
FAQ
인터넷 없이 쓸 수 있나요?
로컬 모델을 한 번 받아 두면 임베딩과 검색은 내 PC에서 돌아요. 처음 모델을 받을 때는 인터넷이 필요해요.
질문에 답을 만들어 주나요?
아니요. 지금은 관련 구절을 찾아 보여 주는 단계까지예요. 답변 생성(RAG)은 다음 단계로 남겨 두었어요.
임베딩 제공자를 바꾸면요?
벡터 차원이 달라지므로 다른 --persist-dir이나 --collection을 써야 해요.
마무리
PDF에서 한국어 구절을 페이지까지 정확히 찾는 기반을 먼저 다진 프로젝트예요. 다음 글에서는 이 위에 RAG를 올려 볼게요.